我不是机器人控制专家。
但从软件 Agent 的角度看具身智能时,我一直有一个很直接的问题:
为什么一定要让一个大模型学会控制整台机器人?能不能让机器人把自己的能力暴露成 Tool,再由 Agent 学会使用机器人?
在软件世界里,Coding Agent 不会自己模拟 CPU 指令。它通过文件系统、Shell、Git、浏览器和各种 API 改变外部环境。
同样,机器人也可以把身体能力暴露成一组接口:
navigate(location)
inspect(object)
grasp(object)
place(object, location)
open(container)
speak(text)
get_force_sensor()
用户只需要说“把桌子收拾一下”,Agent 负责理解目标、观察环境、选择能力、处理失败,真正的轨迹规划、碰撞检测、力控和电机控制仍由更适合它们的系统完成。
这个区别很重要:
具身智能未必需要让大模型学会“控制机器人”,也可以让机器人提供可靠的能力,让 Agent 学会“使用机器人”。
Agent 应该决定做什么,而不是电机下一毫秒怎么转
软件 Agent 调错一次接口,可能只是任务失败或文件损坏。机器人做错一个动作,可能撞到人、夹伤手、打翻热水,或者损坏设备。
因此,LLM 不应该直接进入高频电机控制循环。
现实中的运动控制往往需要几十、几百,甚至上千次每秒的反馈。它关心的是关节位置、速度、力矩、轨迹误差和稳定性,需要确定、可预测、能够在严格时间限制内完成的控制逻辑。
Agent 擅长的是另一类问题:
- 用户真正想完成什么;
- 当前环境中有哪些可用能力;
- 应该先做什么、后做什么;
- 哪一步失败了,是否应该重试;
- 当前能力不足时,是否需要调用更强的模型或询问用户。
所以更合理的结构,不是让 LLM → Motor 直接相连,而是把职责分层:
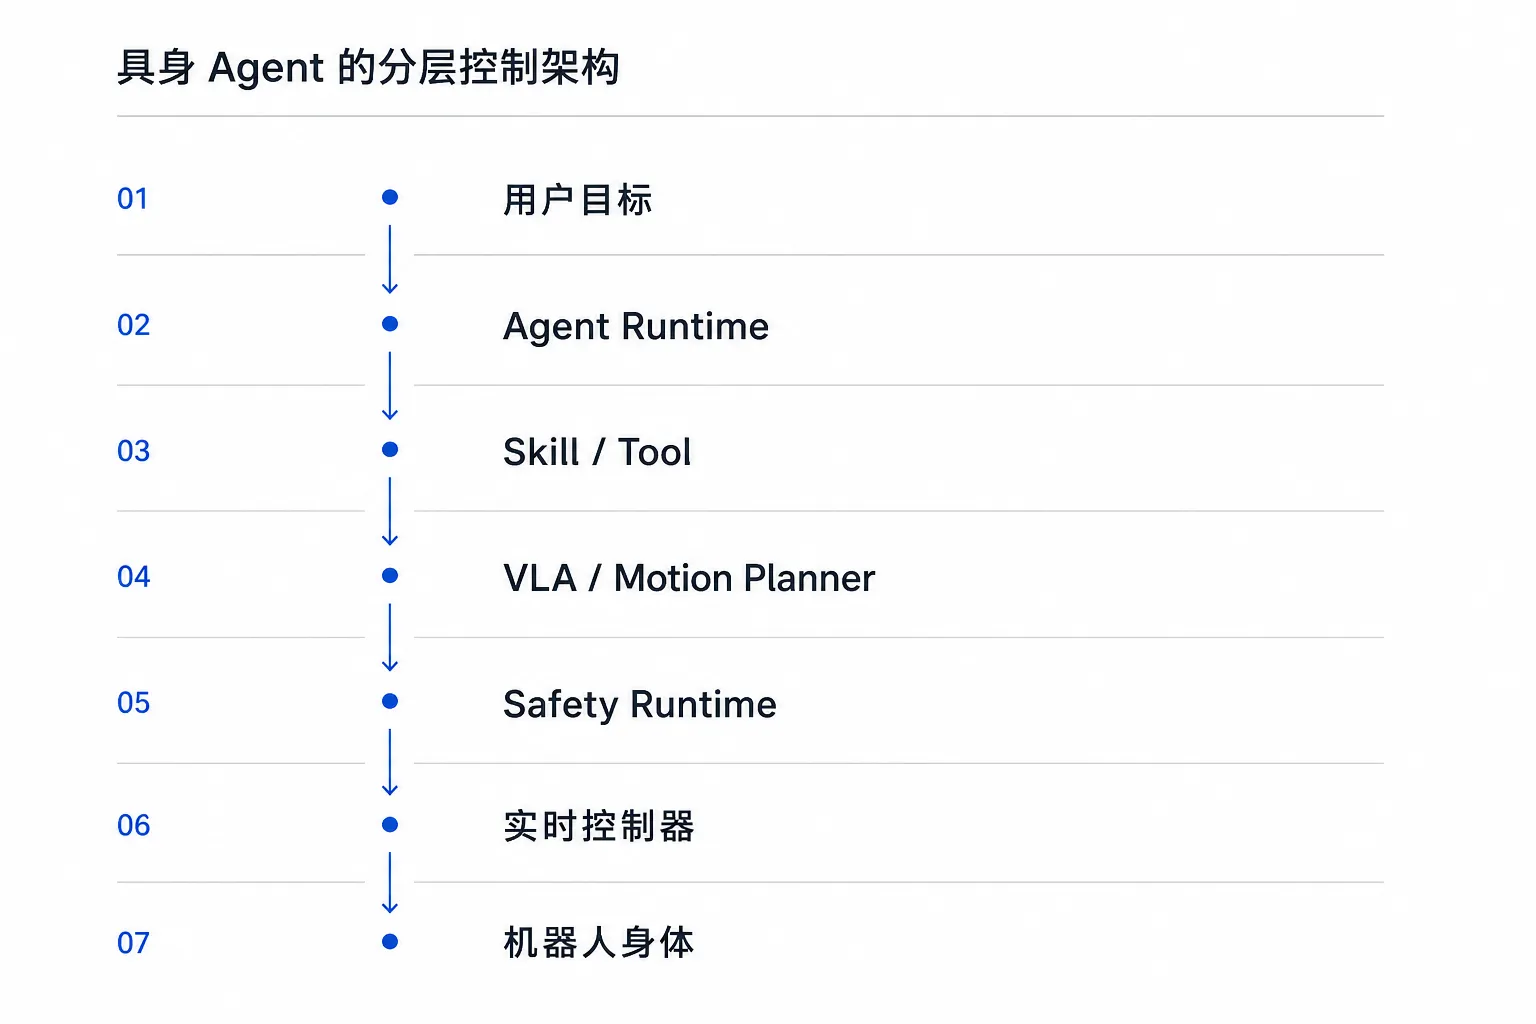
这里每一层解决的问题不同。
Agent Runtime 负责目标、上下文、记忆、规划和能力选择。Skill 把一类任务的可靠做法封装起来。VLA(Vision-Language-Action,视觉—语言—动作模型)或运动策略负责那些难以写成离散步骤的连续动作。Safety Runtime 判断动作当前是否允许执行。最底层控制器负责真正的实时闭环。
这不是为了把架构画得复杂,而是为了避免让一个概率模型同时承担语义理解、任务规划、安全判断和实时控制四种性质完全不同的责任。
Tool 不是一个函数,而是 Agent 作用于世界的接口
从 Agent 的视角看,API、CLI、人、另一个 Agent 和一台机器人没有那么本质的区别。
它真正关心的是:
这个能力能做什么?
输入和输出是什么?
当前是否可用?
调用成本是多少?
需要什么权限?
可能造成什么风险?
失败以后会返回什么?
能不能取消?
因此,机器人的 Tool 不应该只是一个没有语义的控制函数。一个可供 Agent 使用的 navigate(),至少应该告诉 Agent:目标位置、预计时间、当前进度、是否可取消、失败原因和环境约束。
机器人行业其实已经有一些适合承载这种抽象的基础设施。例如 ROS 2 Action 就是带反馈、可取消、可抢占的长时远程调用;官方文档直接用“让导航系统移动到某个航点”作为例子。Nav2、MoveIt 2 和 ros2_control 则分别提供导航、运动规划和控制层能力。
这些系统不是专门为 LLM Agent 设计的,但它们说明:
机器人能力本来就可以被封装成具有状态、反馈和失败语义的高层调用。
Agent 需要的不是绕过这些系统,而是在它们上面增加适合模型理解的能力描述、权限、风险和执行约束。
一个模糊目标如何变成机器人动作
假设用户说:
去厨房给客人拿两瓶水。
Agent 不需要生成每个关节的角度。它可以把任务组织成:
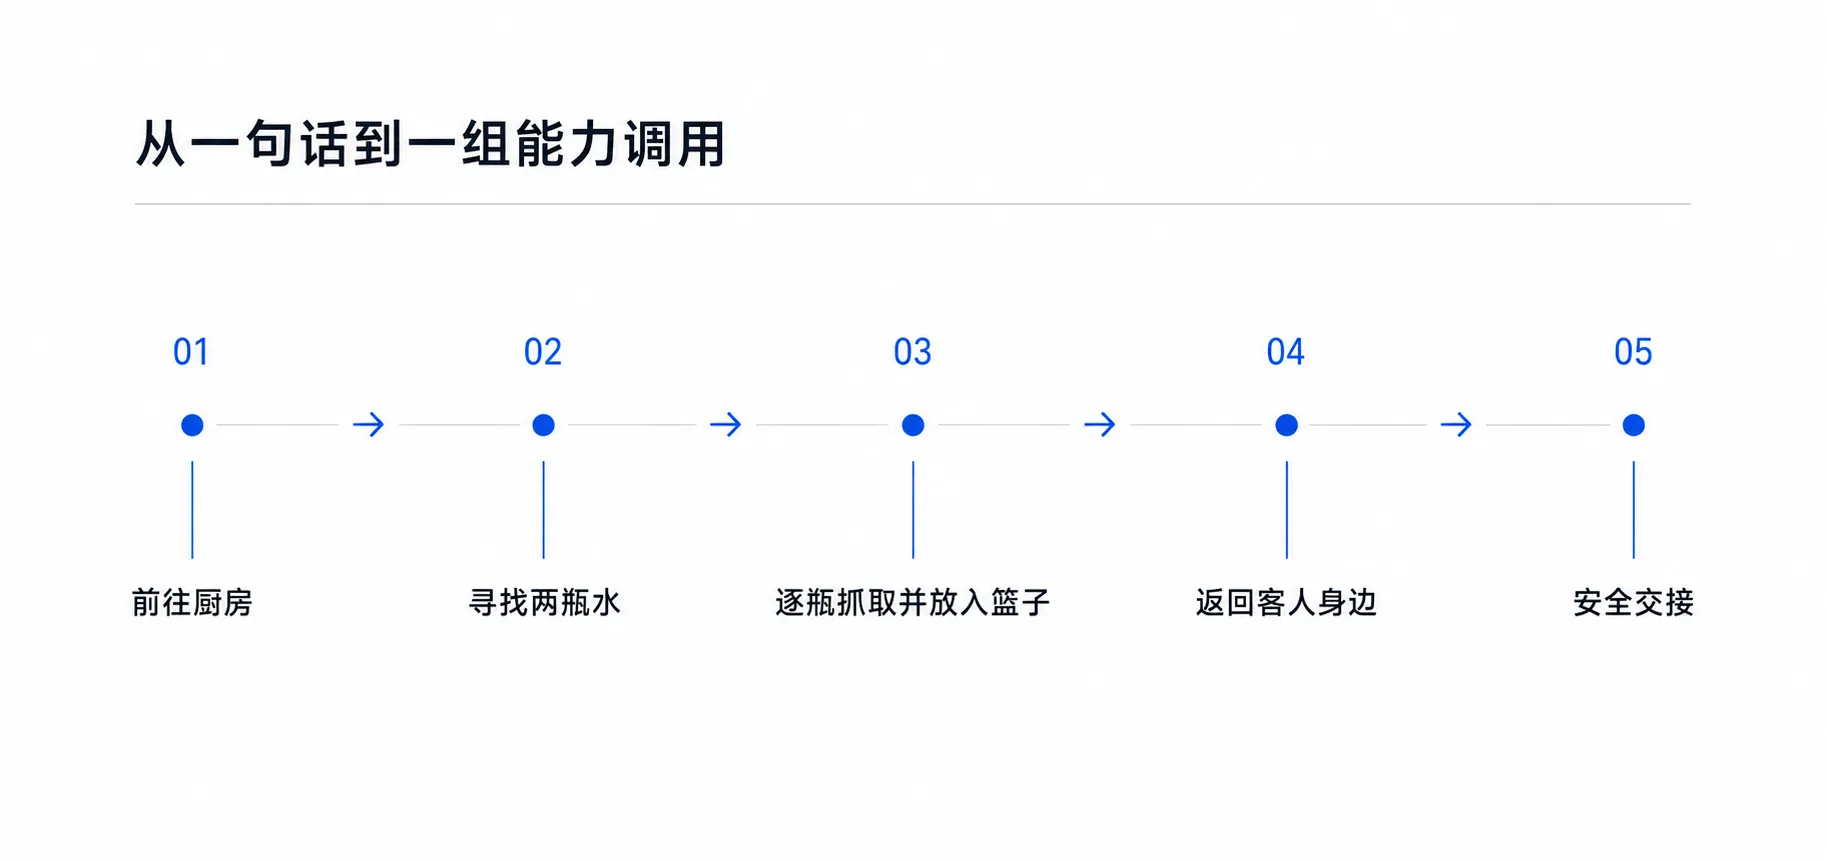
这里的 navigate_to() 可能由 Nav2 执行;grasp_with_vla() 可能是一个学习得到的动作策略;handover_with_vla() 会结合视觉、触觉和人体距离连续调整动作;Safety Runtime 则在整个过程中限制速度、工作空间、抓取力和人与机器人的距离。
Agent 负责组织能力,而不是取代能力。
这带来一个很有价值的结果:基础能力可以重新组合。
只要机器人已经具备移动、观察、抓取、放置和交接,Agent 就可能组合出“拿水”“整理桌面”“把快递放到储物柜”等以前没有专门写过完整流程的任务。
这种分层相对纯 VLA 有什么价值
VLA 的典型形式是:
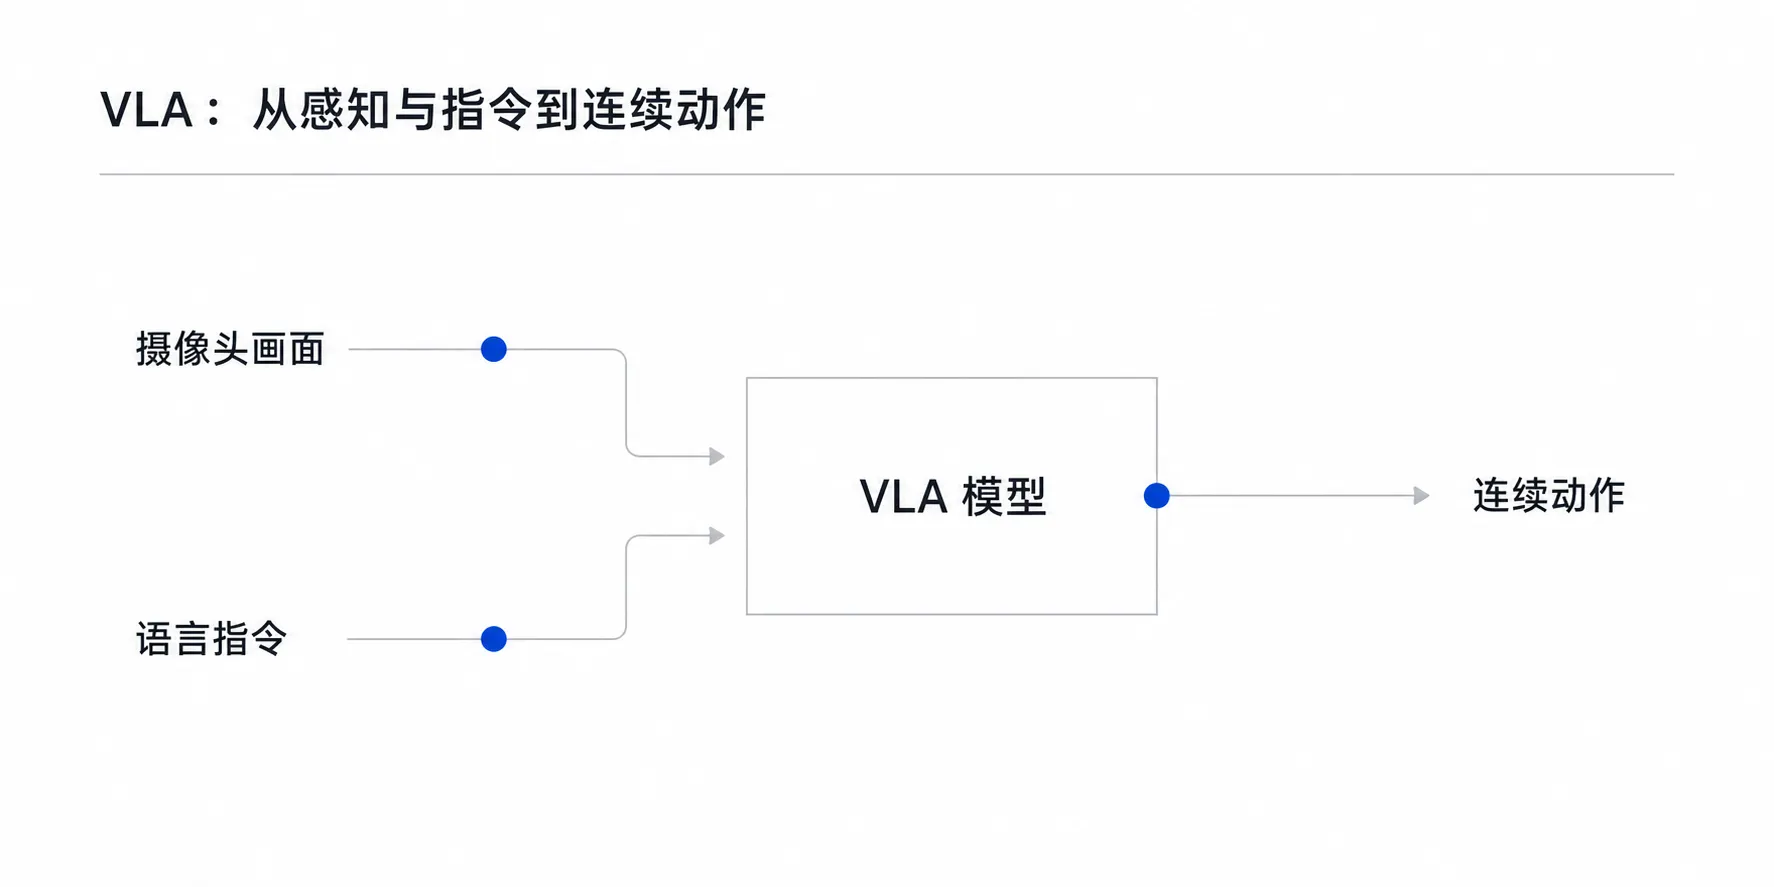
这条路线有明显优势。视觉、语言和动作可以在同一个模型中共同学习,特别适合抓取柔软物体、插入零件、根据触觉微调等强耦合、连续变化的身体技能。
OpenVLA 就是一个代表性项目。它是一个 7B 参数的开源 VLA,使用约 97 万段真实机器人演示训练,目标是让机器人动作策略能够通过微调适配新任务。
但端到端模型并不意味着机器人系统只需要一个模型。分层 Agent 架构仍然有几项难以替代的价值。
能力可以组合
新增一个 Tool 或 Skill,可能立即扩展一整类任务,而不必为每个新目标重新训练完整模型。
过程可以观察
系统可以回答:Agent 为什么选择这个 Skill、调用了哪个能力、失败发生在哪一步、使用了什么证据。
安全边界更清楚
Agent 可以提出动作,但没有绕过安全检查直接驱动硬件的权限。不同风险等级可以使用不同审批、速度和执行空间。
模型与身体可以解耦
上层模型可以更换,本地机器人也可以更换。只要能力契约稳定,部分 Skill 和任务逻辑就有机会复用。
物理数据可以用在真正需要它的地方
语言理解、任务分解和常识推理可以利用通用模型;昂贵的机器人数据集中训练连续动作和物理交互能力。
所以更现实的问题不是“Agent 还是 VLA”,而是:
Agent 应该负责哪些决策,VLA 应该负责哪些动作,它们之间怎样交换状态与约束。
VLA 完全可以成为 Agent 的一个强大 Tool。
这条路线已经有人在做,但还没有形成标准架构
2022 年的 SayCan 已经展示过非常接近的思路:语言模型判断某个 Skill 对目标是否有用,机器人价值函数判断它在当前环境中是否可行,系统再综合两者选择下一步。
Google 公布的 PaLM-SayCan 结果中,系统选择正确 Skill 序列的比例为 84%,成功执行的比例为 74%。它还允许通过添加 Skill 描述、价值函数和提示示例,把新能力加入候选集合。
这证明了“语言模型负责任务语义,机器人模型负责现实可行性”不是纯粹的概念。
另一条路线则试图把更多规划和动作能力放进统一模型。Google DeepMind 的 RT-2 可以同时从图像和文字指令中规划并预测动作;OpenVLA 等开源项目继续降低研究和适配门槛。
但到今天,这些能力还没有组成一个类似软件 Agent 生态的通用标准。行业仍然缺少:
- 面向 Agent 的机器人 Tool Schema;
- 可以跨不同身体复用的 Skill 契约;
- 统一的权限、审批与 Safety Runtime;
- 对真实世界状态和动作后果的可靠记录;
- 让 Agent、VLA、规划器和控制器协同工作的通用运行时。
因此,更准确的判断不是“没人这样做”,而是:
任务规划、机器人 Skill、VLA 和传统控制都已经存在,但把它们组织成完整 Agent Runtime 的工程范式仍处于早期。
本地大脑、云脑和认知路由
如果机器人长期依赖云端大模型,网络断开以后,它可能突然失去最基本的理解和规划能力。
另一种思路是让本地模型成为主体,云端模型只负责扩展。
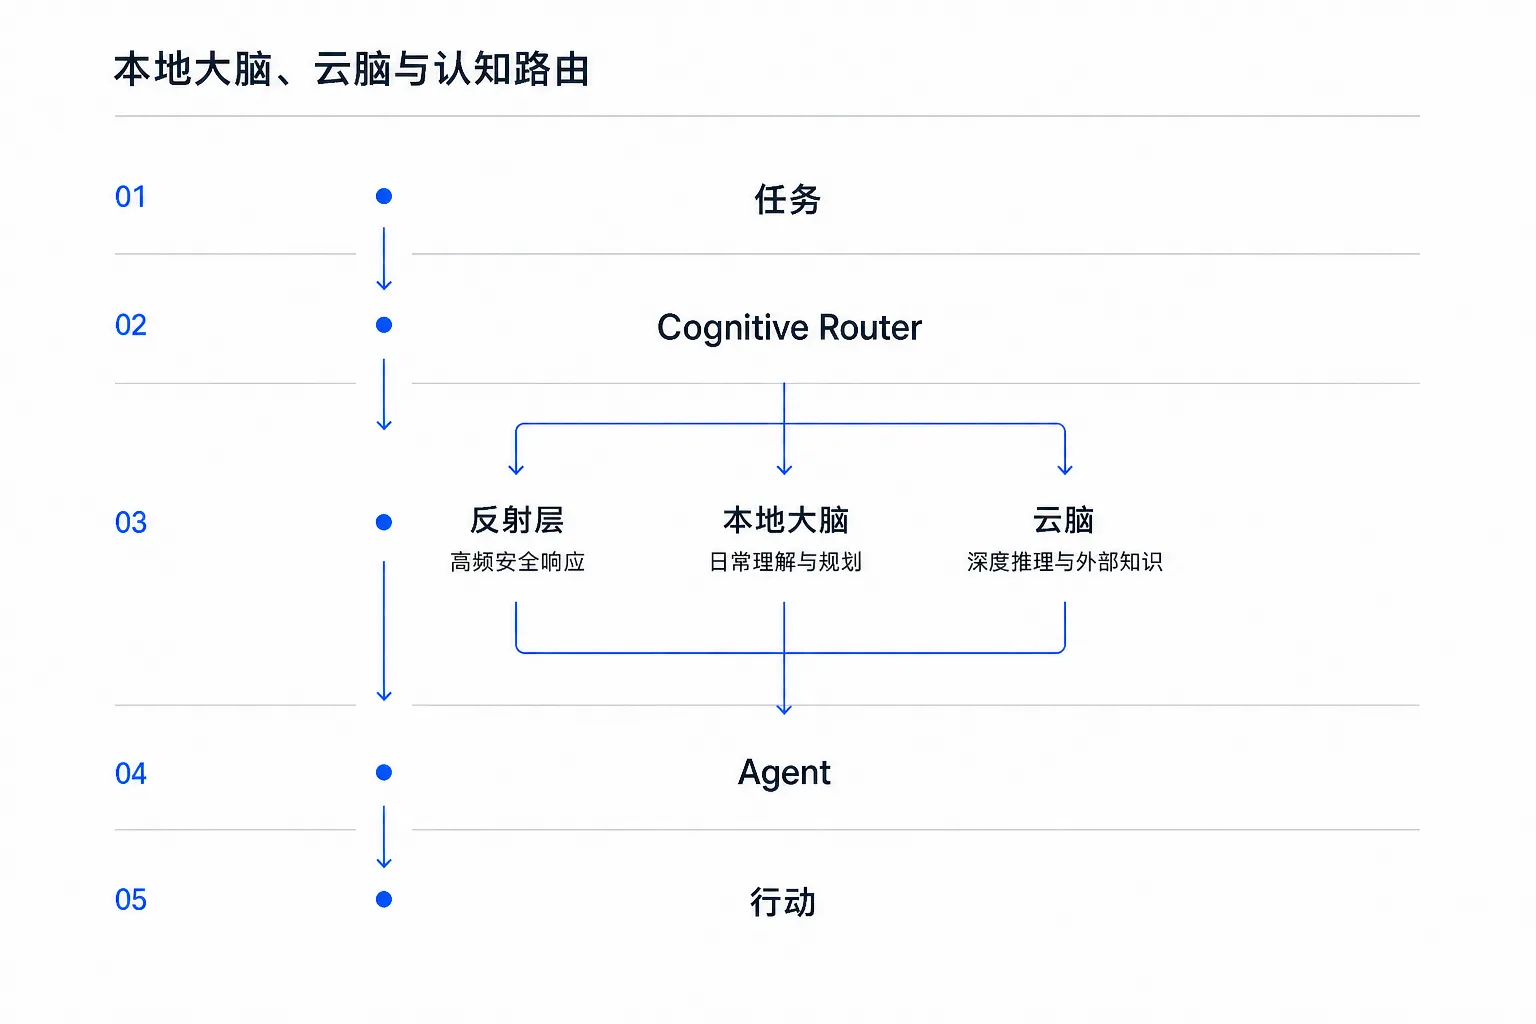
日常语言理解、常见环境判断、Tool routing 和基础规划可以在本地完成。遇到陌生设备、复杂知识或长时间推理时,再把云端 Agent 当作一个 Tool 调用。
这不是简单的“边缘模型加云模型”,而是认知路由:
机器人不需要永远运行最强的模型,而应该为当前问题选择最合适的模型。
这个结构还有一个产品层面的意义:本地大脑定义机器人的基本人格与能力,云脑扩展它能处理的问题。
Taalas 真正提示的不是更快聊天,而是更高频的认知闭环
Taalas 的 HC1 把 Llama 3.1 8B 模型紧密实现到专用硅片中。Taalas 官方公布的数据是每位用户约 17,000 tokens/s。
这个数字不能直接等同于“机器人能在几十毫秒内完成决策”。完整延迟还包括输入预处理、视觉编码、Prefill、Runtime 调度、Tool 执行和环境反馈。
而且 HC1 目前是技术演示系统:官方列出的服务器功耗为 2.5 kW,芯片使用台积电 6 nm 工艺,面积 815 mm²。它不是已经可以塞进家庭机器人的低功耗本地大脑。
但它揭示了一种可能性:模型调用不一定永远昂贵而缓慢。
今天依赖远程模型的 Agent loop,经常要在行动之间反复等待。如果稳定模型的本地推理足够低延迟、低成本,认知闭环就可能明显缩短:
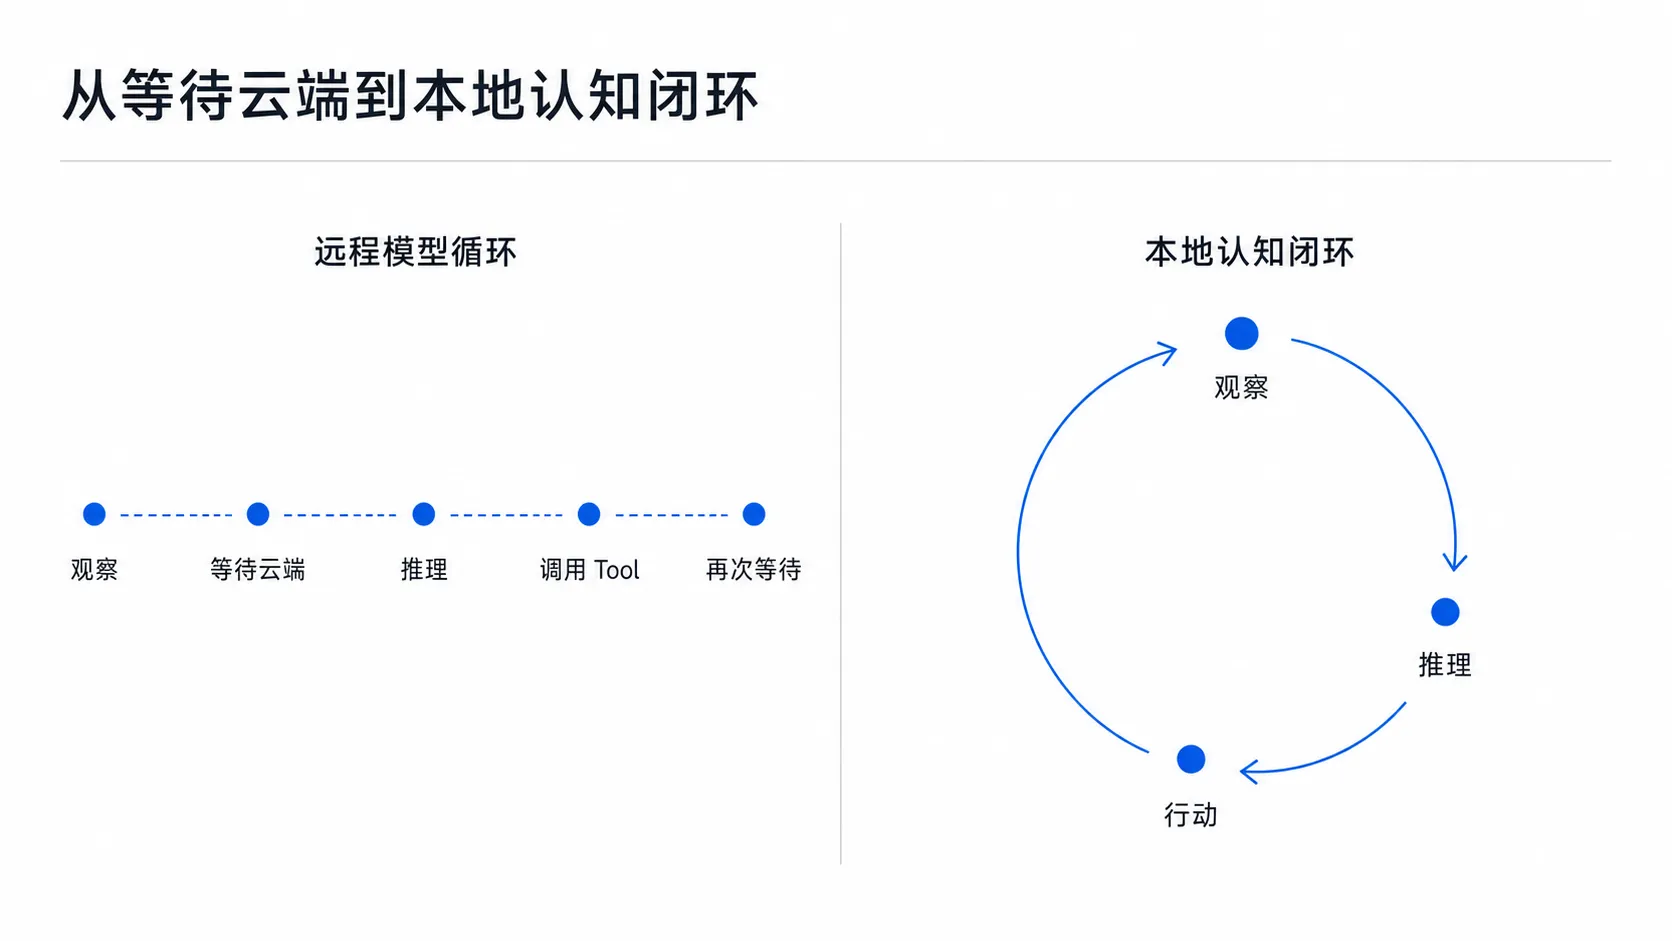
这会提高机器人的“认知闭环频率”。一个模型是否聪明固然重要,但它多久才能观察、判断并修正一次行动,同样会直接影响机器人给人的智能感。
固化模型的代价是灵活性。但机器人高频变化的部分未必是底层模型权重。Prompt、Skill、Tool、Memory、Policy 和任务流程都可以在应用层更新。本地稳定模型负责常用认知,复杂问题交给可更新模型或云端 Agent,可能是一条更现实的混合路线。
物理世界里的 Tool 必须比软件 Tool 更严格
“万物皆可成为 Tool”并不意味着 Agent 可以无限制地调用万物。
一个合格的机器人 Tool 至少需要包含:
- 明确的前置条件和输入约束;
- 可观察的执行状态和超时机制;
- 可取消、可暂停或可安全停止;
- 对速度、力量、空间和对象类型的限制;
- 失败后的安全状态;
- 权限、风险等级和必要的人工确认;
- 与现实环境一致的传感器证据。
而且数字世界中的“回滚”不能直接套用到物理世界。
机器人可以撤销一条尚未执行的命令,却不能真正撤销已经打翻的杯子。系统能做的是停止后续动作、进入安全状态、记录现场、评估补救方案,并在高风险时把控制权交还给人。
这也是为什么 Safety Runtime 不能只是写在 Prompt 里的几条规则。它必须有独立于大模型的传感器、约束、控制逻辑和硬件保护。
真正的变化,是把智能从模型问题变成系统问题
具身智能经常被描述成寻找一个更强的端到端模型。
模型当然重要,但一台能够长期工作的通用机器人,最终还要面对能力组合、运行状态、权限、安全、失败恢复、本地与云端协同,以及不同时间尺度的控制问题。
这些问题不可能只靠模型参数解决。
我更愿意把未来机器人理解成一套分层神经系统:
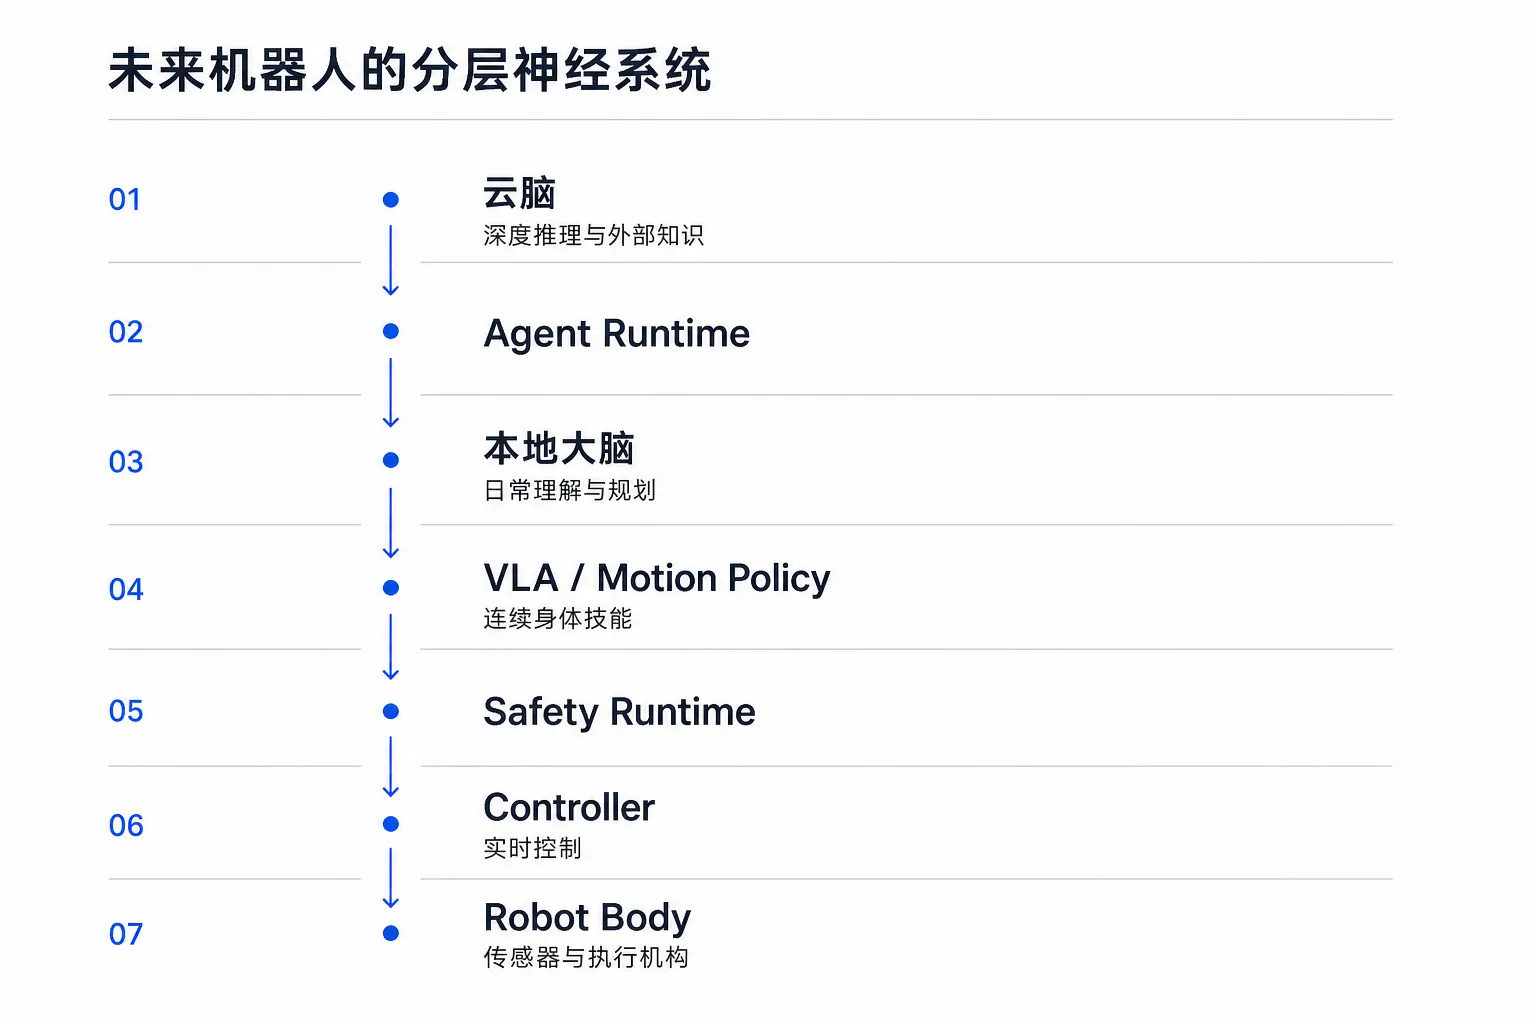
在这个结构里,机器人既可以运行自己的 Agent,也可以成为更高层 Agent 的 Tool。VLA 既可以是一个模型,也可以是 Agent 调用的动作能力。云端 Agent 既是更强的大脑,也只是另一个外部 Tool。
于是“万物皆工具”不再只是软件 Agent 的比喻。
函数、API、CLI、人、Agent 和机器人,都可以成为智能系统作用于世界的接口。
真正需要解决的,是如何让这种作用保持可理解、可约束,并且足够安全。
讨论
留下第一条评论
这里还没有讨论。评论通过自动检查并写入博客后,会显示在这里。
参与讨论
使用 GitHub 确认身份。评论会经过自动检查,并公开保存到博客的 Git 历史中。
正在检查 GitHub 登录状态……
首次登录会前往 GitHub 授权,只读取公开用户名、头像和个人主页。