太长不看版:AI agent 的技能、记忆、提示词是一堆会自己生长的 Markdown 文件。我们给它们套了一层 Git(不改任何代码、一个下午),七天 76 个 commit:升级踩踏 54 秒救回补丁、行为突变查表定位,也摔了三次敏感信息入库的跤。这篇文章回答六个问题——原生机制是什么、它好在哪缺什么、Git 为什么能无痛挂上、挂上的收益与代价、这是长期架构还是 Hack、官方路线有没有重叠。
开篇:问题是什么
这一代 agent 不是聊天机器人,是会长期工作、顺手修改自己的系统。我们团队内部跑着一个这样的 agent(Hermes,Nous Research 的开源项目,常驻进程 + CLI,通过飞书协作):
- skills/ 两百多个技能目录,每个是一份
SKILL.md工作说明书——怎么发邀请邮件、怎么整理纪要、催办用什么语气,都是它自己写的 - memories/ 跨会话记忆;SOUL.md 人格;config/ 各自动化流程的提示词
- 每天凌晨两点扫团队群聊建任务台账,早八点发日程简报,周一扫开源贡献者发邮件
这一个月它自己改自己的次数,比我们所有人加起来都多。于是三个“没人答得上”的问题出现了:
- 它变成什么样了?(说不清)
- 这条规则哪天、被谁、为什么改的?(查不到)
- 改坏了怎么退回上周三?(回不去)
先说透问题:语义的冻结与发散
传统软件本质上也是一套语义系统,它最原始的语义来自代码。
但传统软件有一个非常重要的特点:在版本发布的那一刻,它的语义基本被冻结了。代码、配置、依赖共同决定了软件会如何运行,并且在发布之前,还会经过开发、测试和质量工程体系的验证。因此,只要输入和环境确定,它的行为通常是稳定、可预测、可复现的。
Self-improving Agent 则完全不同。
它是一套更加复杂,而且持续变化的语义系统。除了 Agent 自身的代码,还有 Memory、Skill、Soul、定时任务、脚本、补丁、插件,以及大语言模型在运行过程中不断生成和修改的内容。这些东西都是 Agent 的「原始语义」,任何一处变化,都可能影响 Agent 最终的理解、判断和执行结果。
更关键的是,这些语义变化往往发生在运行时,并不会像传统软件发布一样,每一次都经过测试工程师和质量体系的验证。
于是会出现一个很重要的问题:
一个 Self-improving Agent 修改自己越多,它内部积累的语义就越复杂;语义之间发生冲突、覆盖、漂移和产生意外组合的可能性也就越高。
所以 Self-improving 真正困难的地方,可能并不是「如何让 Agent 修改自己」,而是如何管理一套持续变化、持续扩张,并且缺少人工逐次验证的语义系统。
如果没有版本管理、变更追踪、冲突检测、回滚和验证机制,那么所谓的「自我进化」,最终很容易从能力的持续积累,变成一次不可控的语义发散。
我们的解法:给家目录 git init。以下六问六答。
问一:原生机制到底是什么?
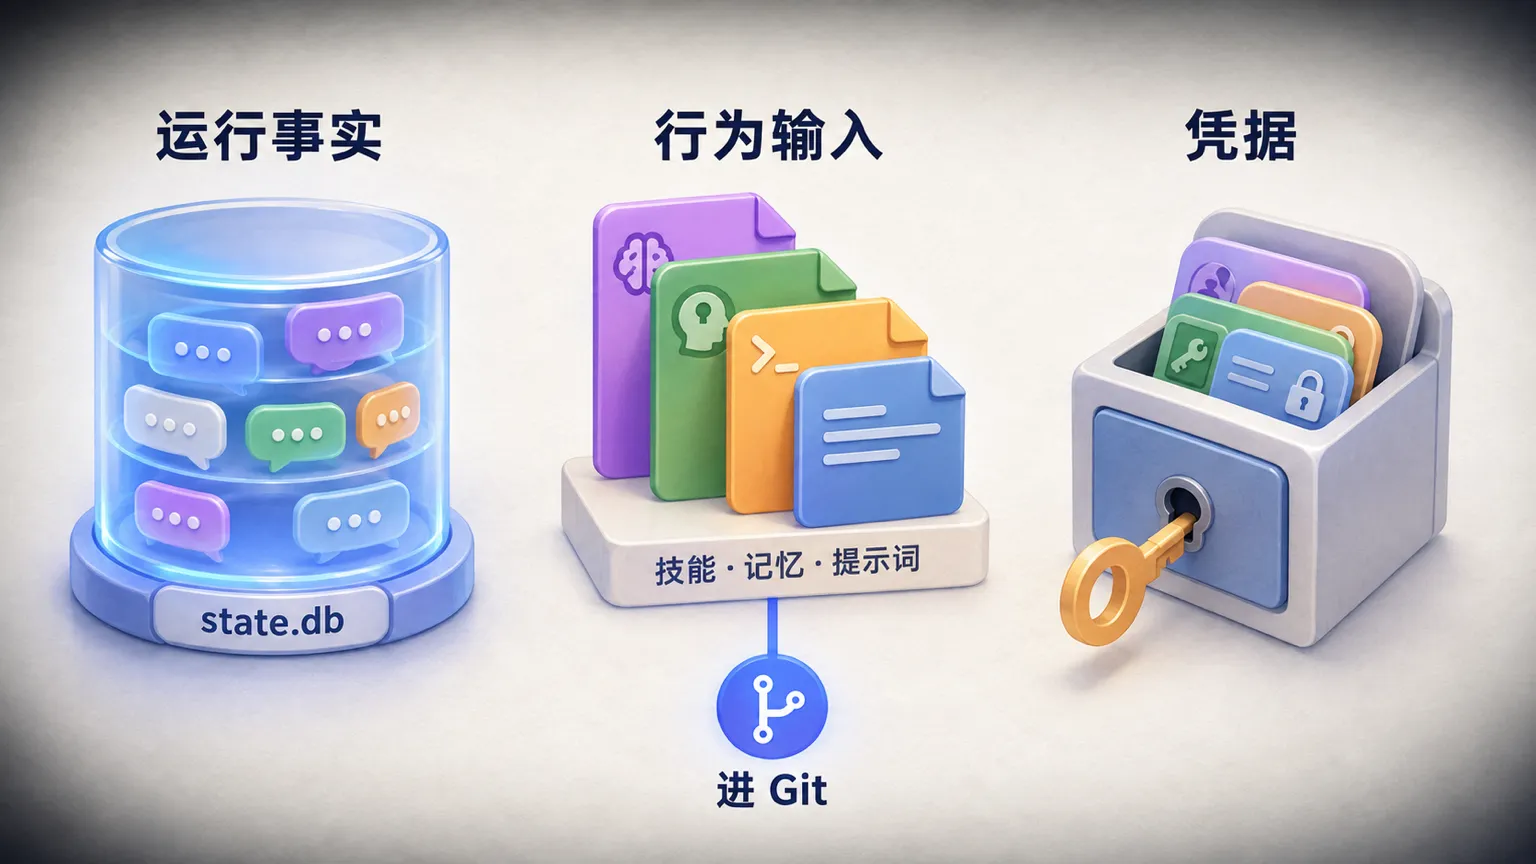
它的数据不是“一个目录”,是三个世界混住:
| 世界 | 内容 | 载体 | 官方保护 |
|---|---|---|---|
| 运行事实 | 每条消息、工具调用、会话路由、租约 | state.db(1.1 GB SQLite,schema v30,三十余张表,FTS+trigram 中文索引,WAL 模式) | 升级前自动快照;hermes backup ZIP 整档 |
| 行为输入 | 技能、记忆、人格、提示词、脚本 | 散装文本文件,扫描式加载 | 备份 ZIP 捎带;整理器跑前 tar 技能树;一个默认关闭的可选 Checkpoint(影子 Git,每项目 20 恢复点) |
| 凭据 | .env、auth.json、token | 散落文件 | 无,自己管 |
三个读源码才知道的细节:
- 备份是数据库感知的:对每个
.db走 SQLite 在线备份 API,不是复制正在写入的文件——这个设计是对的 - 但快照会静默跳过你的数据库:单文件超 1 GiB 不进升级快照,只在 manifest 记一笔。我们实测最新两份升级快照真的没有 state.db——“存在快照”不等于“数据库有备份”
- 加载没有强一致性协议:技能有 30 秒 TTL 发现缓存、
.bundled_manifest记来源 hash 供升级比对;记忆在会话内是冻结快照(换文件不影响进行中的会话,下个会话才生效)。有刷新边界,但没有“必须走官方 API 才认账”的一致性索引——这是问三的关键伏笔
问二:原生机制的好处、坏处、不足
好处(别为了上 Git 贬低原生):
- 备份是事务一致的,不是
cp正在写的文件 - ZIP 整档简单可靠:换机器、灾备,一个文件全带走
- 快照自动挂钩升级流程,事前留档的心智负担为零
不足(一句话:副本 ≠ 版本)——ZIP 和 tar 回答“某时刻存了什么”,版本管理要回答的是另外五个问题:
| 问题 | 原生答案 |
|---|---|
| 相对哪一版改了什么? | ❌ 无 diff |
| 为什么改? | ❌ 无人话记录 |
| 只退一个文件? | ❌ 只能整档恢复(或开那个影子 Git 实验功能) |
| 两条改法怎么合? | ❌ 无 merge |
| 哪些机器该运行哪个版本? | ⚠️ 分发在做(见问六),历史是空白 |
官方 issue 区挂着“技能写入即提交”的提案,未指派——需求存在,实现未到。
问三:为什么 Git 能无痛挂上?
流行答案是“因为 agent 的大脑是纯文本”。这只对一半——GitHub 上被单个 2MB JSON 折磨的仓库多的是,文本性本身不值钱。真正让外挂成立的四个条件,我们逐条对过源码:
- 文件是“输入”,不是“状态”。技能和提示词是 agent 下次工作时读取的声明;声明可以版本化,事实(消息、租约)必须交给事务协议。这是整件事的物理学
- 加载无跨文件一致性要求。磁盘内容变了,下次加载就是新的——没有“必须通知索引/走 API 才生效”的门卫。所以外部换文件,合法有效
- 变更频率与历史价值匹配。技能一个月改两次,每次都值得一个 commit message;state.db 一秒写十行,每行留史等于灾难
- 文件边界接近语义边界。一个技能目录 ≈ 一种能力,正文+脚本+参考文档一起评审、一起回滚
合起来是一条一般原理:
当系统行为由低频、文本、“文件即权威”的声明驱动,运行事实另有可靠存储时,外挂版本层就是自然设计。
dotfiles 社区二十年前就这么管 Linux 配置了。agent 没有发明新模式,它只是把“配置即文本”的旧世界重新放大:配置变成了大脑。增量变化只有一样——改文件的不再只是人,还有 agent 自己,频率高一个数量级,还不会主动写变更日志。
顺带堵住最常见的抬杠——为什么 state.db 不进 Git:不是 Git 存不了二进制,是四个实际不匹配:
- WAL 模式的事务时刻拆不进逐文件 staging
- 一条消息在页/索引层面散成多处字节差异,diff 没有人类可读性
- 两台机器各自追加的消息,Git 无法理解语义地合并
- 旧租约复活会让已完成的工作重跑
数据库有数据库的协议。外挂 Git 的正确姿势恰恰是承认自己管不了全部。
问四:挂上之后的收益与代价
收益:五个现场(都有 log 可查)
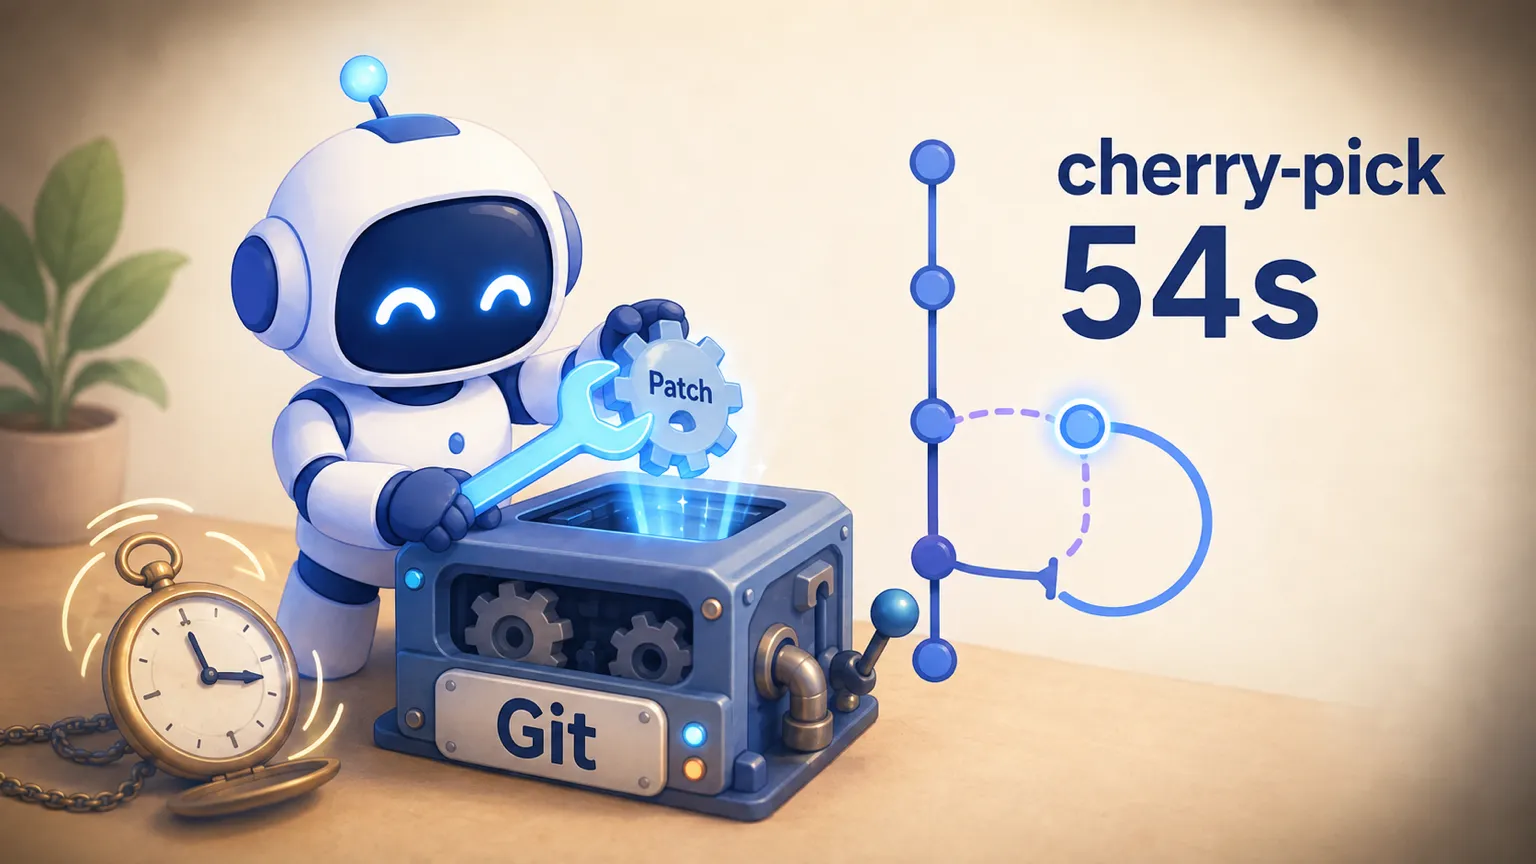
1. 升级踩踏 → 54 秒救火。9/4 官方升级把内层代码仓库 reset 到上游,我们在飞书适配层打的两个定制补丁一夜蒸发——那里面是晨报卡片的拦截逻辑和勾选并发锁。因为补丁以 commit 存在:git reflog 翻出哈希 → 两条 cherry-pick → reflog 时间窗 54 秒 → 体检脚本确认 5 个 marker 全就位。(诚实边界:54 秒是仓库内窗口,发现—验证—重启全流程更长;这局救火的是代码仓库的 Git,外层仓库的贡献是把“用哪份补丁、按什么顺序、跑什么验收”写成 README 和版本化 patch 文件留在现场。没有版本化之前,这类事故的标准处置叫“照着记忆重写一遍”。)
2. 行为审计:从玄学变查表。某天自动消息的措辞不对劲。git log -p 五分钟定位:前一天凌晨的跑批任务改了追问话术——diff 里是 runbook 中 --text 裸链接 变成 --markdown [标题](链接) 的那几行,commit message 写着“太啰嗦,改标题超链接”。谁、哪天、改了什么、为什么,全部可回放。
3. AI 可以独立审查整个大脑。把仓库丢给另一个模型做只读审查,产出 21KB 报告——它真的能逐文件理解这个 agent“会什么、记着什么、哪些规则互相矛盾”。当天揪出三处我们自查没发现的边界事故。文件系统+Git 是今天所有 agent 互审的公约数接口。
4. 接手成本趋近于零。仓库根放一份 README-VERSIONING.md:这是什么、三条边界、恢复三步(git log 找基线 → git show <commit>:<path> 取文件 → 跑体检脚本验收)。接手者可以是任何人——或者一台新机器上刚 clone 的全新 agent。
5. 最意外:commit message 成了 agent 的外置长期记忆。我们要求自动化收尾的 commit 写人话带因果。跑了一阵发现,新会话读家目录时会把 git log 当材料——它开始知道“自己上周为什么改了催办语气、为什么把身份从 A 换成 B”。一个为人类设计的机制,顺手喂饱了机器的失忆症。这可能成为标准件:agent 的长期记忆,一半在 memory 文件(该记住的),一半在版本历史(做过什么决定的完整流水账)。
代价:三次事故,平均一天一跤
只讲收益的文章都是没挨过打的文章。这段是本文存在的一半理由。
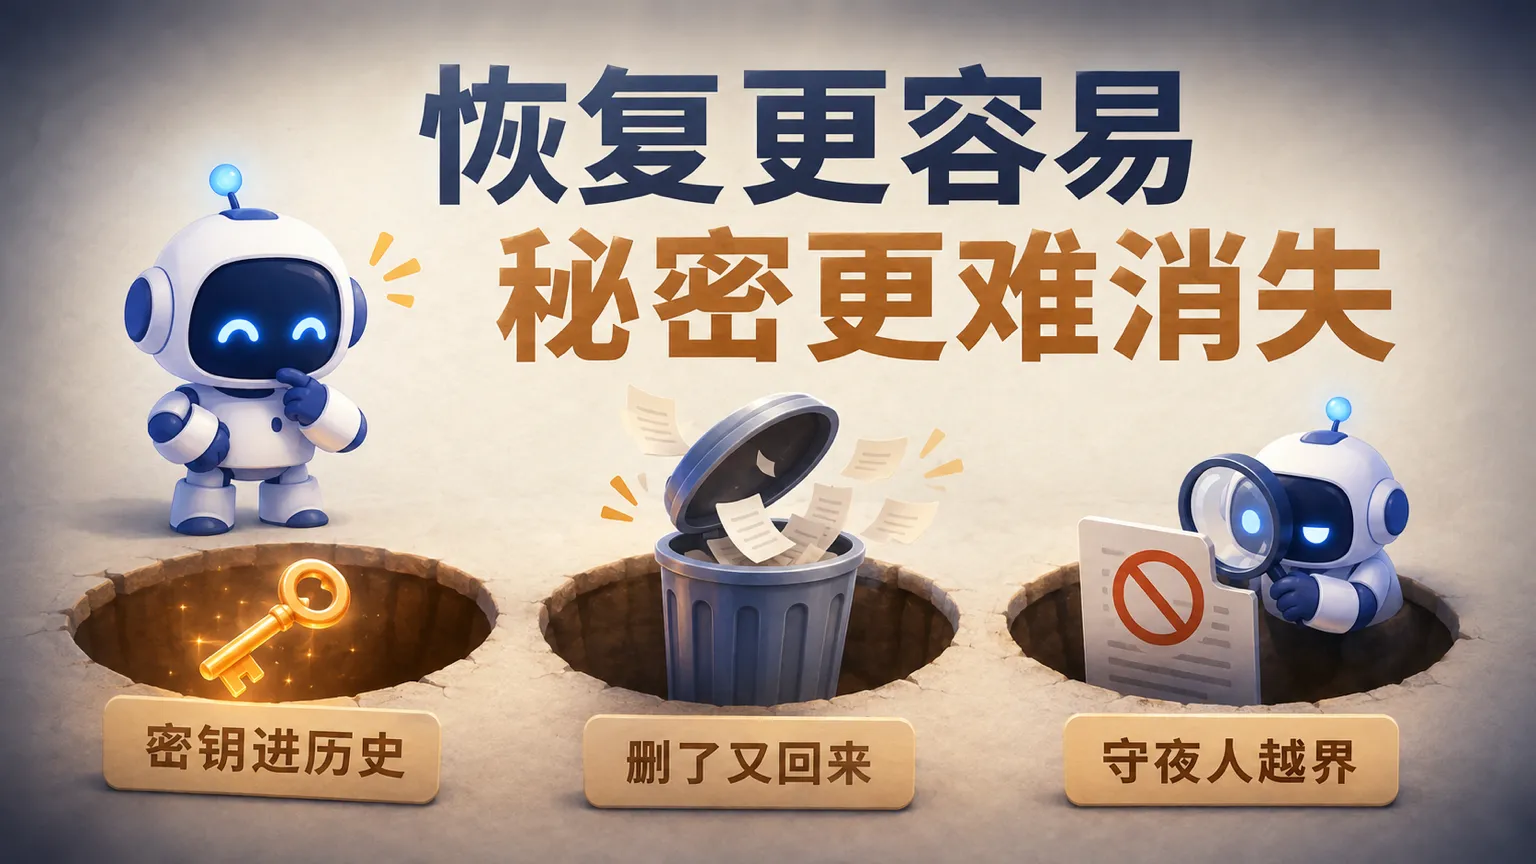
跤一:历史里翻出活密钥。建库前的全历史扫描发现,一份业务快照里躺着一把真实可用的 API key——它在建库之前就躺在目录里,Git 一进来就忠实地把它变成“永久历史的一部分”。处置三件套:git rm --cached → filter-repo 全历史重写(55 条 commit 映射、哈希全变、强推覆盖远端、GitHub 后台慢慢 GC 缓存副本)→ 最后才是真正要紧的一步:去服务端轮换这把 key。
教训一:Git 让删除变得固执。路径删除、历史清除、凭据作废是三件事,做两件等于没做。
跤二:清掉的东西第二天自己复活。一类内部备份(208 个文件)八月底就移出过跟踪、也写了 ignore 规则。第二天它们回来了——规则写的是 skills/.curator_backups/,这批躺在根目录,路径没罩住;而把它们重新吸进仓库的,恰恰是我们自己的纪律:“每日跑批收尾 git add -A”的自动化,忠实地把每条边界缝隙放大成事故。
教训二:ignore 不是橡皮擦,也不是分类器;自动提交纪律会把边界的每一条错漏认真执行。
跤三:守夜人自己越界。每日体检里有一项敏感扫描,实现是“遍历家目录”。它遍历了什么?几乎全部——包括那份我们立了铁律“任何 AI 不得读取”的配置文件。相当于雇了个机器人,每天定时把禁区读进一个会上报的上下文,持续三周,最后被外部独立审查抓出来。修复是双层的:扫描改白名单目录 + 硬排除写死代码 + 给“扫描器不得越界”本身写负向测试(往禁区放探针文件,扫描器要是报告了它,体检直接失败)。
教训三:检查者比被检查者更需要边界。
三跤摔完,安全模型才算成型——四层里每层都是一跤换来的:
路径排除 → 内容级凭据扫描 → 白名单遍历 → 越界负向测试然后是本篇最反直觉的一句总结:
Git 让 agent 更容易恢复,也让它的秘密更难消失。
资产的每一次改进和每一次误入库,用的是同一套“忠实复制、永久留存”的机制。版本化是一台双刃的时光机。
问五:这是长期架构,还是 Hack?
正方——值得长期:
- 零侵入是完备性不是巧合:agent 对 Git 无感知,Git 挂了 agent 照常跑
- 模式有二十年先例(dotfiles),工具链通用(log/diff/checkout 谁都会)
- 它是目前唯一能让“第三方 AI 审查 agent 资产”成立的形态
反方——Hack 成分是真的:
- Git 没有“机密”概念,边界永远靠人维护(七天三跤是物证)
- 双仓漂移(代码仓 + 数据仓)要靠纪律缝合;运行态噪音和资产混在同一个工作树,ignore 漏一条、自动提交就放大一次
- clone ≠ 恢复:数据库、凭据、外部授权都不在仓库里。“新实例秒级满血复活”是话术,不是事实
我们的裁决:
有纪律的外挂是正当架构,没纪律的外挂是定时炸弹——而纪律恰好全部可以自动化:内容扫描、白名单、每日体检、越界测试、README 恢复手册。五件套配齐,一个周末下午搭起来的旁挂方案,可以当长期基础设施用。
体面的退休条件也写下来了:当官方把“资产变更即提交、单文件恢复、冲突协议”做成默认能力时(见问六),外层仓库应收敛为灾备副本+演化历史。到时候拆得不心疼,因为资产本来就在自己的分支上。
问六:官方仓库和 roadmap 有没有重叠?
我们真的把 hermes-agent 的源码、releases、issue 区翻了一遍(带链接的证据在文末附)。三块拼图:
| 官方动向 | 状态 | 与本方案的重叠 |
|---|---|---|
| Profile Distribution——用 Git 仓库作为来源,发布、安装一整套 agent profile;本机私有状态(记忆/会话/凭据)明确不归它管 | 已交付(v0.21 线) | 高。“发布与分发”这块官方有了,我们该把这部分迁过去 |
Skill Sync——跨设备技能同步,skills_sync_client.py 源码已在 | 存在,但带预发布门控,不能假定普通用户可用 | 中。盯着,门控解除再评估 |
| Checkpoint(影子 Git)+ 升级快照 + backup/import | 已交付 | 低。解决“改写撤销/灾备”,不解决“资产长期历史” |
| “技能写入即提交”(skill writes as commits)提案 | open issue,未指派 | 官方知道这个需求,没人排期 |
三选一裁决:部分重叠。 不是“官方已覆盖、我们白干”,也不是“官方无规划、我们是唯一解”——
- 该迁移的:将来资产要对外发布(比如把技能开源给团队),走官方 Profile Distribution,别再自己发明
- 该保留的:任意长期的资产演化历史、本地脚本与定制的可审查性、跨 AI 会话的决策流水账——官方短期/范围化机制不覆盖这些,这是外层仓库的长期生态位
- 该警惕的调研纪律:issue 标题不是 roadmap 承诺,预发布代码不是人人可用。我们差点在报告里把“有源码”写成“官方支持”,被独立审查拦下
一句话展望:官方路线和我们殊途同归——都认定 agent 的行为资产该有版本与发布协议。它从平台侧做,我们从运维侧做。谁的先长成默认,另一个就优雅退场。
如果你想抄作业
适用判断三问:你的 agent 行为由文本声明驱动吗?它(或你)会持续改这些声明吗?团队真的靠它干活吗?三个“是”就做,一个下午的工程;有任何一个“否”,ZIP 备份够了。
三句前提,全是学费:
.gitignore先于第一次git add,内容级凭据扫描必须在首次提交之前跑,不是之后——历史越短,重写的代价越小- 自动提交纪律必须配白名单,
git add -A是一把会把你每条边界错误认真执行的枪 - 接受 Git 管不了的部分:它不保证同一个 commit 重放出同一场对话(模型服务、检索结果、上下文都在变),更不能当保险箱——private 仓库不是加密
最后留一个我们没解决、今天也没有任何工具能解决的问题:
文件能回滚,理解不能。技能退回上周三是 git checkout 的事;但“agent 对某件事的认知”退回上周三——记忆作为文本进了版本库,记忆作为认知,还活在每天的上下文压缩里,压过去就没了。
版本化的下半场,是给“理解”做 Git。那是下一台时光机的事。
附:证据索引
| 事实 | 出处 |
|---|---|
| state.db schema/表结构/WAL | Hermes 源码 hermes_state_schema.py、live DB 只读检视 |
| 备份的数据库感知与 1GiB 阈值 | 源码 hermes_cli/backup.py、update_cmd.py;本机 state-snapshots/*/manifest.json 实测 |
| 技能缓存/manifest/记忆快照语义 | 源码 tools/skills_tool.py、tools/skills_sync.py、tools/memory_tool.py |
| Profile Distribution / Skill Sync | 官方仓库 hermes_cli/profile_distribution.py、tools/skills_sync_client.py 及 release notes |
| 54 秒救火、55 条重写映射、208 文件复活 | 内外层仓库 git reflog / .git/filter-repo/commit-map / 清理 commit 的 diff-tree 统计 |
数字口径说明:文中 76 commit、2113 文件、168+40 等均为仓库实测快照值,会随日常运转变化;“54 秒”“三周”是日志时间戳口径,不是全流程耗时。
讨论
留下第一条评论
这里还没有讨论。评论通过自动检查并写入博客后,会显示在这里。
参与讨论
使用 GitHub 确认身份。评论会经过自动检查,并公开保存到博客的 Git 历史中。
正在检查 GitHub 登录状态……
首次登录会前往 GitHub 授权,只读取公开用户名、头像和个人主页。